Dans le champ de l’IA appliquée au contrôle qualité, l’indicateur global de performance conserve une utilité limitée lorsqu’il est isolé de l’analyse des erreurs. Un modèle peut produire un taux d’exactitude élevé tout en échouant sur les cas minoritaires qui concentrent le risque industriel. Cette situation se rencontre fréquemment lorsque les pièces conformes représentent la majorité des observations, tandis que les défauts critiques restent peu présents dans les données. L’apparente stabilité du score masque alors une fragilité méthodologique.
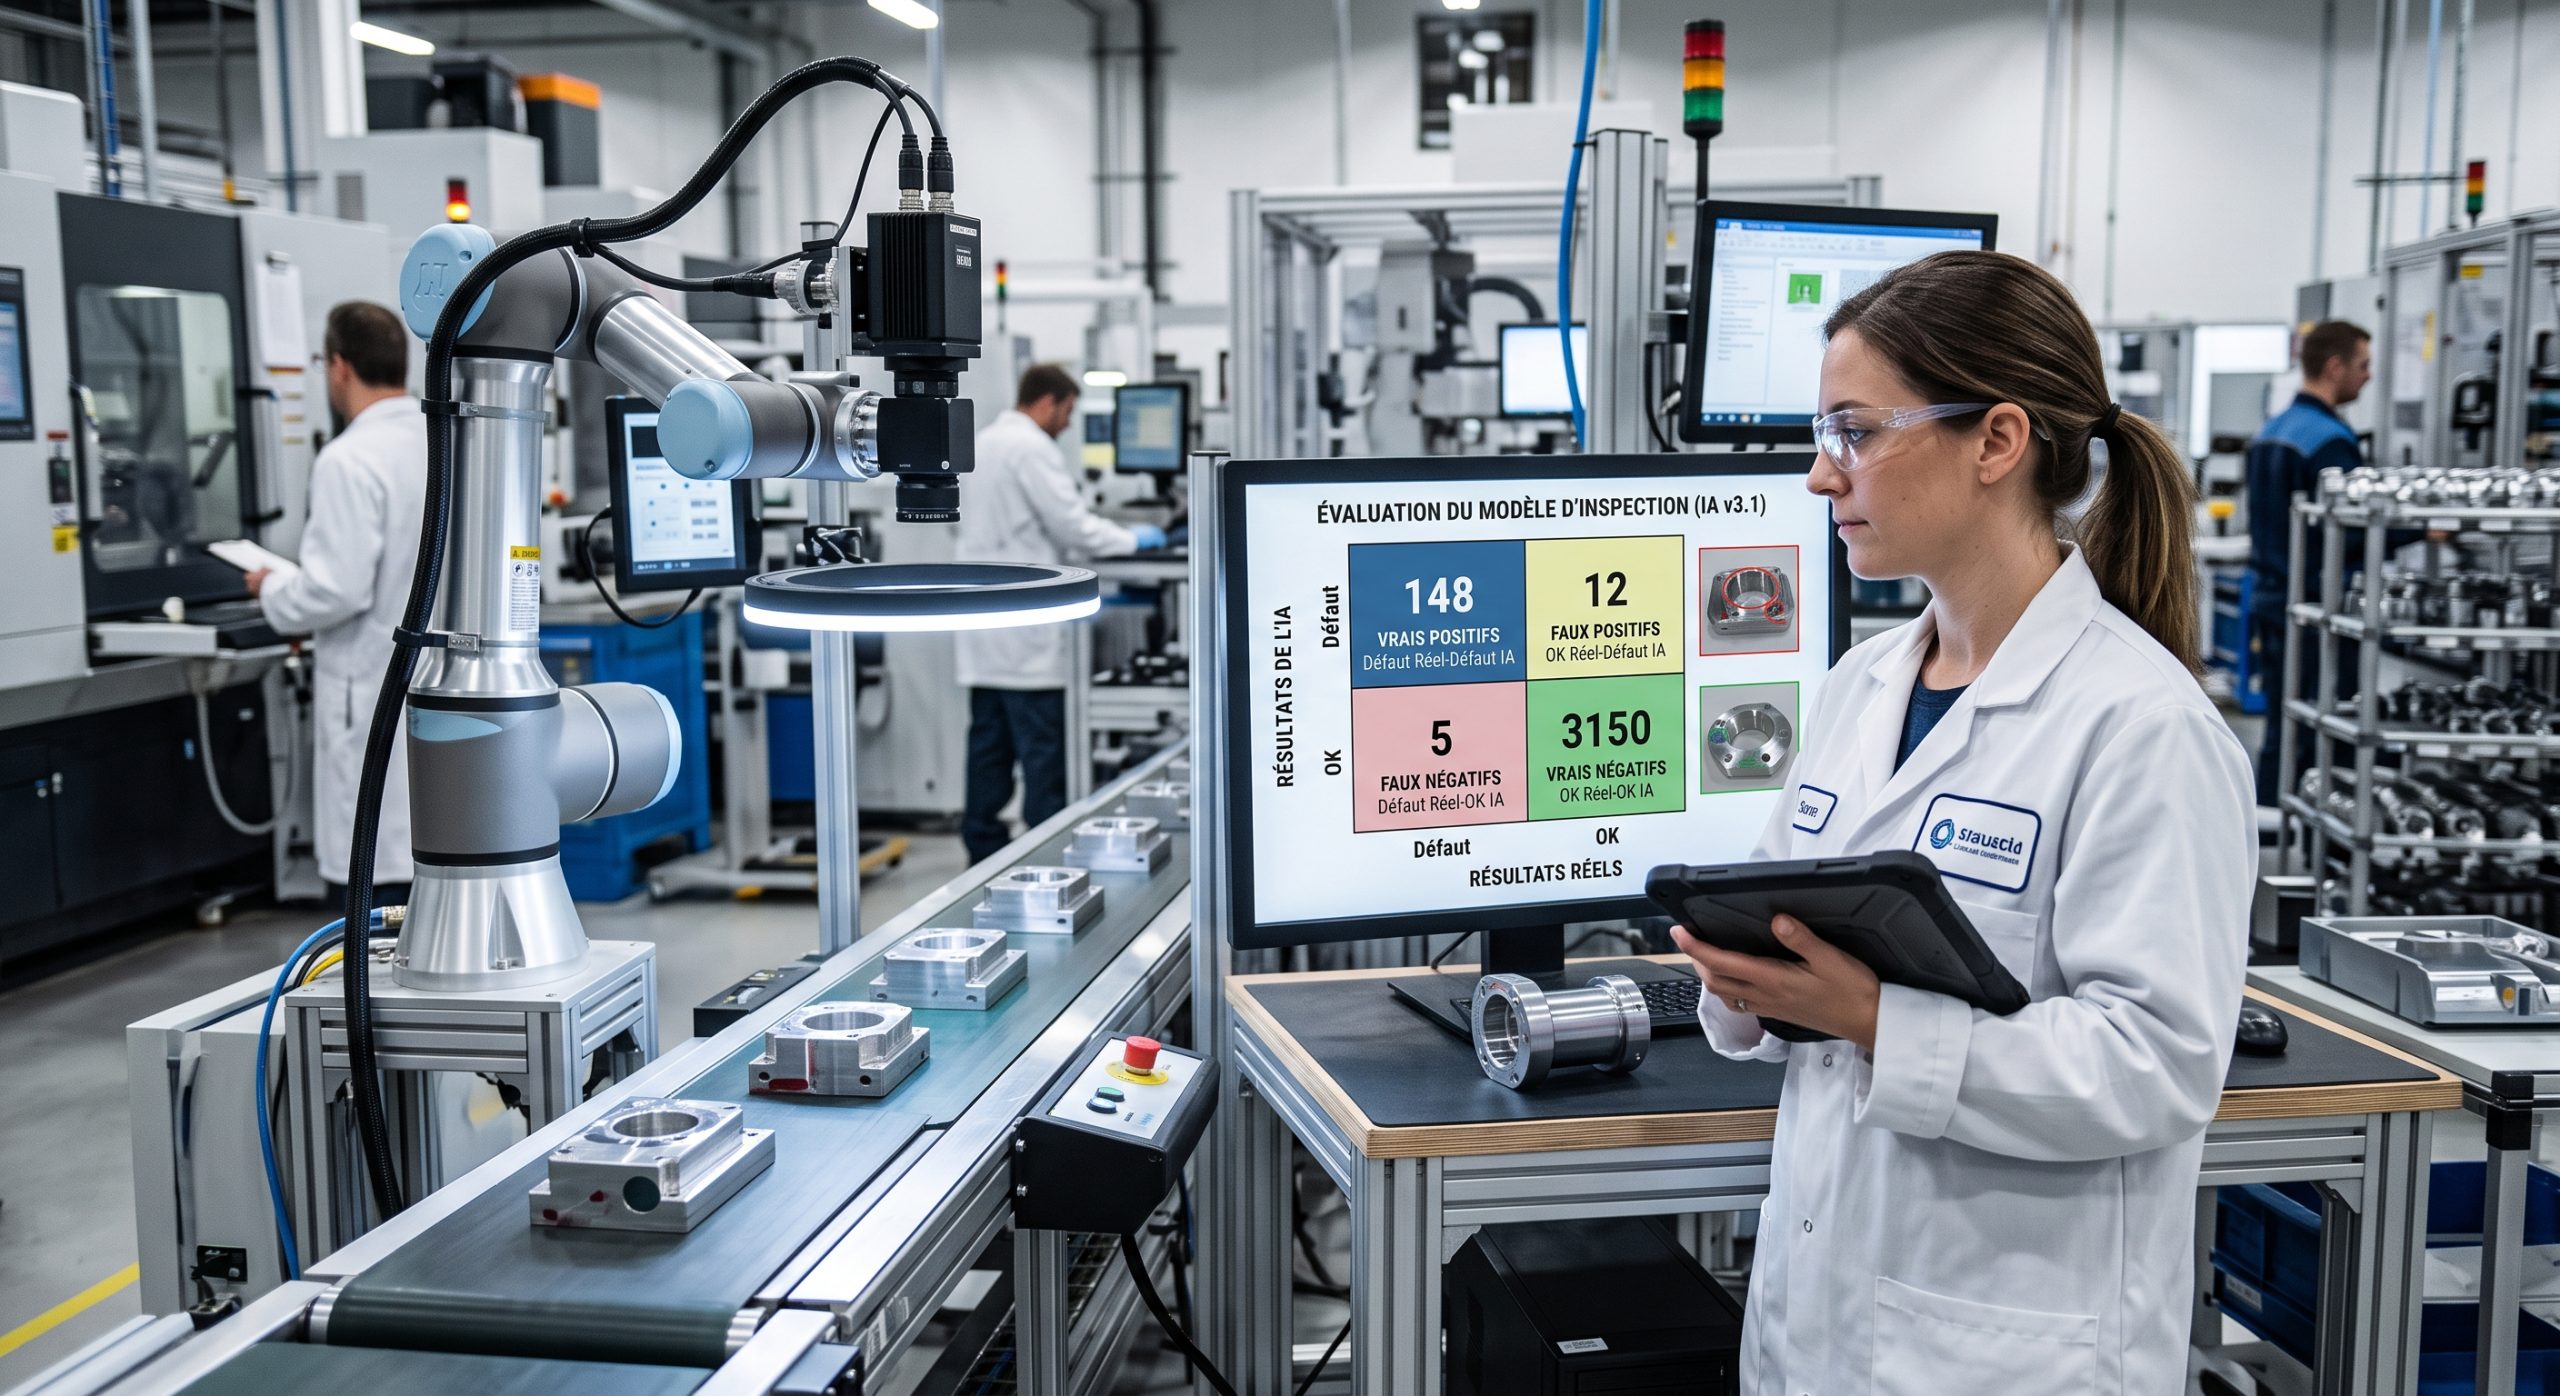
La matrice de confusion apporte une lecture plus rigoureuse. La documentation scikit-learn la définit comme un tableau dans lequel chaque cellule indique le nombre d’observations appartenant à une classe réelle et prédites dans une classe donnée. Cette représentation ne se contente donc pas de compter les succès ; elle localise les confusions du modèle. Dans un système de vision industrielle, elle distingue par exemple les pièces conformes correctement acceptées, les pièces conformes rejetées à tort, les défauts détectés et les défauts laissés dans le flux de production.
Cette granularité modifie la discussion entre data scientists, responsables qualité et décideurs techniques. Au lieu de demander si le modèle est “bon”, il devient possible de demander où il se trompe, avec quelle fréquence et dans quelles conditions. La question est moins spectaculaire, mais elle se révèle plus utile. Elle invite à examiner les classes rares, les défauts ambigus, les écarts d’annotation et les situations visuelles proches des limites de décision.
Pour un blog data science ou IA, cet angle présente un intérêt particulier : il relie une notion statistique classique à une problématique industrielle concrète. Le tableau n’est plus un simple artefact d’évaluation ; il devient un support d’interprétation. C’est précisément cette articulation entre mesure, risque et décision qui explique l’intérêt d’un approfondissement dédié à la matrice de confusion en vision industrielle.
Faux positifs et faux négatifs : une lecture orientée risque
La matrice de confusion prend toute sa valeur lorsque ses cellules sont traduites en conséquences opérationnelles. Dans un cadre binaire, un vrai positif correspond à un défaut correctement détecté, tandis qu’un vrai négatif correspond à une pièce conforme correctement acceptée. Le faux positif désigne une pièce saine que le système rejette. Le faux négatif désigne un défaut non détecté. Cette distinction paraît élémentaire ; elle détermine pourtant la stratégie de déploiement.
Le faux positif crée un coût de friction. Il mobilise un opérateur, ralentit la cadence ou augmente les reprises manuelles. Le faux négatif crée un coût de risque. Il peut laisser sortir une pièce non conforme, déclencher une réclamation client, provoquer un tri ultérieur ou dégrader la confiance accordée au contrôle automatique. Ces deux catégories d’erreurs ne doivent donc pas être pondérées de façon uniforme.
Dans un atelier de conditionnement, par exemple, un rejet injustifié d’étiquette peut être récupéré par un contrôle manuel. À l’inverse, une série d’étiquettes mal imprimées non détectées peut atteindre un distributeur et imposer un traitement plus coûteux. Dans une entreprise de pièces mécaniques, le même raisonnement s’applique aux défauts de surface, aux bavures ou aux anomalies dimensionnelles visibles. Le modèle ne s’évalue pas seulement en fonction de sa capacité à classer ; il s’évalue en fonction de la criticité des erreurs qu’il produit.
Les métriques complémentaires permettent d’objectiver cette lecture. Google for Developers rappelle que précision, rappel et score F1 sont calculés pour un seuil donné et que ces métriques évoluent lorsque ce seuil change. La précision décrit la fiabilité des alertes émises. Le rappel décrit la capacité du système à retrouver les vrais défauts. Le score F1 résume un compromis, mais il ne remplace pas l’analyse métier. Une PME ne devrait donc pas rechercher un score unique supposé universel ; elle devrait expliciter le coût relatif des erreurs.
Un principe de gouvernance simple peut être appliqué dès la phase pilote. Chaque type d’erreur doit être associé à une conséquence : contrôle opérateur, blocage du lot, revue qualité, réentraînement ou acceptation documentée. Cette démarche oblige l’entreprise à formaliser sa tolérance au risque. Elle transforme une matrice technique en outil de gestion industrielle, ce qui facilite les décisions entre direction, production et prestataire IA.
Seuil de décision : la performance dépend du réglage autant que du modèle
Il serait réducteur de considérer la matrice de confusion comme un résultat définitif. Dans de nombreux systèmes de classification, le modèle produit d’abord un score de confiance. Un seuil transforme ensuite ce score en décision. Modifier ce seuil change la répartition entre vrais positifs, faux positifs, vrais négatifs et faux négatifs. Autrement dit, la matrice observée dépend à la fois du modèle, des données de test et de la politique de décision retenue.
Les ressources pédagogiques de Google sur les seuils de classification décrivent ce rôle de conversion entre score et classe prédite. Pour l’inspection visuelle, cette notion a une portée très opérationnelle. Un seuil plus strict peut accroître la détection des défauts, mais il risque d’augmenter les fausses alertes. Un seuil plus permissif peut fluidifier la ligne, mais il peut aussi laisser passer davantage d’anomalies. Le compromis acceptable dépend du produit, du client, du contrat qualité et de la capacité de reprise manuelle.
Il convient donc de comparer plusieurs matrices de confusion avant de formuler une conclusion. Une première matrice peut représenter un seuil équilibré. Une deuxième peut privilégier la réduction des faux négatifs. Une troisième peut limiter les faux positifs afin de préserver la cadence. Cette approche expérimentale donne aux décideurs une vision plus robuste que la simple présentation d’un score maximal obtenu dans une configuration unique.
Le choix du seuil doit également intégrer la distribution réelle des données. Si le jeu de test contient peu de défauts rares, la matrice risque de sous-estimer l’incertitude. Si les images proviennent de conditions trop homogènes, l’évaluation peut ignorer les variations de lumière, de matière, de fournisseur ou d’usure machine. La robustesse d’un modèle d’inspection ne peut donc pas être établie sans un protocole de test représentatif. Le modèle doit être confronté aux cas courants, mais aussi aux cas limites qui structurent le risque.
Un point méthodologique mérite une attention particulière : les images utilisées pour la validation ne doivent pas reproduire trop fidèlement les conditions d’entraînement. Si le modèle est évalué sur des exemples très proches de ceux qu’il a déjà appris, la performance obtenue peut surestimer son comportement futur. Une revue scientifique ou technique du système doit donc documenter la séparation des jeux de données, les familles de défauts présentes, les volumes par classe et les conditions de capture.
De l’expérimentation au pilotage industriel
Une matrice de confusion bien interprétée ne sert pas uniquement à valider ou refuser un modèle. Elle oriente les actions d’amélioration. Si une classe de défauts est régulièrement confondue avec une autre, il peut être nécessaire de revoir la taxonomie qualité, les critères d’annotation ou la prise de vue. Si une classe apparaît mal détectée faute d’exemples, l’effort doit porter sur l’enrichissement du jeu de données. Si les fausses alertes se concentrent dans une zone de l’image, l’éclairage, le cadrage ou la propreté optique doivent être examinés.
Cette analyse révèle souvent que l’erreur n’est pas exclusivement algorithmique. Elle peut provenir d’une ambiguïté métier, d’une nomenclature instable ou d’une divergence entre opérateurs. Lorsque deux experts qualité ne classent pas de façon identique certains défauts, le modèle hérite de cette incertitude. La matrice devient alors un révélateur organisationnel. Elle met en évidence non seulement la performance de l’IA, mais aussi la maturité du processus de contrôle.
Le NIST AI Risk Management Framework fournit un cadre général pour gérer les risques associés aux systèmes d’IA, en insistant sur la nécessité de mesurer, documenter et suivre les systèmes dans leur contexte d’usage. Pour une PME, cette approche peut rester pragmatique. Il ne s’agit pas de produire une documentation excessive, mais de conserver les éléments essentiels : jeu de test, seuil retenu, matrice obtenue, erreurs critiques, décisions métier et plan de surveillance.
La norme ISO/IEC 42001:2023 s’inscrit dans une logique voisine en décrivant un système de management dédié à l’intelligence artificielle. Son intérêt, dans le cas du contrôle qualité, tient à l’idée de gouvernance continue. Un modèle mis en production ne reste pas mécaniquement stable. Une nouvelle référence produit, un changement de fournisseur, un déplacement de caméra ou une dérive du process peut modifier les performances. La matrice de confusion doit donc être actualisée lors des évolutions significatives.
Dans une phase de déploiement progressif, l’entreprise peut d’abord utiliser le modèle en mode observation. Le système émet des alertes, mais la décision finale reste humaine. Cette période permet de comparer les prédictions aux décisions terrain, d’enrichir la matrice avec des cas réels et d’identifier les écarts entre laboratoire et atelier. Lorsque les résultats se stabilisent, le modèle peut être intégré plus fortement au processus, avec des garde-fous adaptés aux classes critiques.
Le critère de réussite n’est donc pas l’absence totale d’erreurs. Un système industriel sans erreur n’est pas une hypothèse réaliste. Le critère pertinent est la connaissance structurée des erreurs restantes, leur acceptation par le métier et l’existence d’un mécanisme de surveillance. Dans cette perspective, la matrice de confusion cesse d’être une figure de rapport. Elle devient un actif de pilotage pour l’IA appliquée au contrôle qualité.
Implications pour les décideurs techniques de TPE et PME
Pour un décideur technique, l’enjeu consiste à rendre l’évaluation compréhensible sans la simplifier excessivement. La matrice de confusion offre ce point d’équilibre. Elle conserve la rigueur de l’analyse statistique tout en permettant une lecture métier immédiate. Elle indique quelles erreurs se produisent, sur quelles classes et avec quelles conséquences probables. Cette visibilité aide à arbitrer entre automatisation, contrôle humain et amélioration du modèle.
Trois pratiques méritent d’être systématisées. D’abord, examiner les résultats en nombres absolus et non seulement en pourcentages. Ensuite, confronter les erreurs observées à une estimation de leur coût industriel. Enfin, conserver l’historique des matrices à chaque version du modèle. Ce suivi permet de distinguer une amélioration réelle d’un simple déplacement d’erreurs entre classes.
Cette discipline présente aussi une valeur relationnelle. Lorsqu’un client, un auditeur ou un donneur d’ordre interroge la fiabilité du contrôle automatique, l’entreprise peut présenter une démarche structurée. Elle peut expliquer comment le modèle a été testé, quels risques ont été identifiés et quelles mesures de surveillance ont été prévues. La crédibilité du projet ne repose plus sur une promesse technologique, mais sur une preuve organisée.
Pour les TPE et PME, cette approche reste accessible. Elle n’impose pas de créer un service data science complet. Elle exige surtout une collaboration claire entre l’intégrateur IA, les équipes qualité et la production. Chacun apporte une partie du raisonnement : métriques, criticité, faisabilité opérationnelle. Lorsque ces trois lectures convergent, la décision de déployer devient plus robuste.
La matrice de confusion, bien utilisée, constitue ainsi un instrument de traduction. Elle traduit des scores en erreurs, des erreurs en risques et des risques en décisions. C’est cette chaîne de traduction qui rend l’IA utile dans le contrôle qualité. Elle permet de passer d’une démonstration technique à un système mesuré, gouverné et améliorable.
Les avantages de la matrice de confusion
L’évaluation d’un modèle d’IA appliquée au contrôle qualité exige une lecture plus fine qu’un simple score global. La matrice de confusion permet d’identifier les erreurs, de les qualifier et de les relier aux risques industriels réels.
Dans un contexte de TPE ou de PME, cette approche offre un avantage décisif : elle rend la performance discutable par tous les acteurs du projet, et non par les seuls spécialistes de la donnée. Elle soutient une décision de déploiement progressive, documentée et adaptée à la criticité des produits inspectés.
Le bon modèle n’est pas celui qui promet l’absence d’erreur. C’est celui dont les erreurs sont connues, surveillées et compatibles avec les exigences qualité de l’entreprise. Avant de généraliser un système d’inspection par IA, il convient donc d’examiner la matrice, les seuils, les données de test et les garde-fous opérationnels.